
AI 怎么做 MV 视频:用纳逗Pro从歌曲做到成片
AI 怎么做 MV 视频:用纳逗Pro从歌曲做到成片
我在纳逗Pro画布里做了一次“雨后天台看信”的无声 MV 视觉试镜:先生成一张定场图,再以它为参考生成约 5 秒的单镜短片。两次提交前估价分别为 3 积分和 7 积分,合计预计 10 积分。这个小样只检验画面延续和轻动作,没有输入歌曲,不代表已经完成卡点、演唱口型或整支 MV。
直接回答: 用 AI 做 MV,应先锁定歌曲版本,标出歌词段落、重音和停顿;再确定角色与视觉参考,逐镜生成短素材,最后在歌曲时间线上剪辑、校对音画和导出。叙事镜头、演唱特写和歌词字幕的验收要求不同。单个画面生成得好看,不足以证明整首歌的节奏、口型和版权问题都已解决。
先把歌曲变成可以执行的时间表
歌曲版本最先定下来。前奏长度或速度一变,已有剪辑点就可能全部需要重排。至少听两遍:第一遍记主歌、副歌、间奏和收尾的起止时间,第二遍记重音、停顿及情绪转折。不懂 BPM,也可以先从这些可听见的变化开始。
下面是一段虚构的约 30 秒副歌 的分镜示例,不是本次画布已完成的镜头数,也不是平台时长限制。制作时应把“副歌进入”等词换成所用歌曲的准确时间码。
音乐位置 | 画面任务 | 验收重点 |
|---|---|---|
副歌进入 | 天台远景交代人物与城市 | 位置和光线方向清楚 |
情绪上升 | 中景停步、低头看信 | 人物、外套与信件连续 |
关键歌词 | 面部或信件特写 | 情绪与歌词对应,不强行逐字配图 |
尾音延长 | 背影或城市空镜 | 画面停留时间足够 |
每镜只安排一个主要动作,比把奔跑、转身、拥抱和流泪都塞进几秒更容易生成和返工。镜头切换要服务于重音、动作完成或情绪变化,不必每一拍都切。
把抽象情绪写成可见镜头
“雨夜、电影感、孤独”只交代氛围,还应写清人物位置、动作、景别、机位和结束状态。例如:雨后天台,一名穿深色外套的成年人站在栏杆内侧,低头看一封信;中景固定机位,远处是蓝灰暮色与暖色窗灯,人物不说话。这样的描述更便于检查信件、衣服和背景是否稳定。
先选能代表人物与场景的参考图,记录发型、衣着、道具、主色和光线方向,再出关键静帧。把静帧按播放顺序排在一起,确认它们像同一支作品后再做动态镜头。参考图能帮助表达目标,不能保证跨镜头完全一致。
真实画布案例:雨后天台的无声视觉试镜
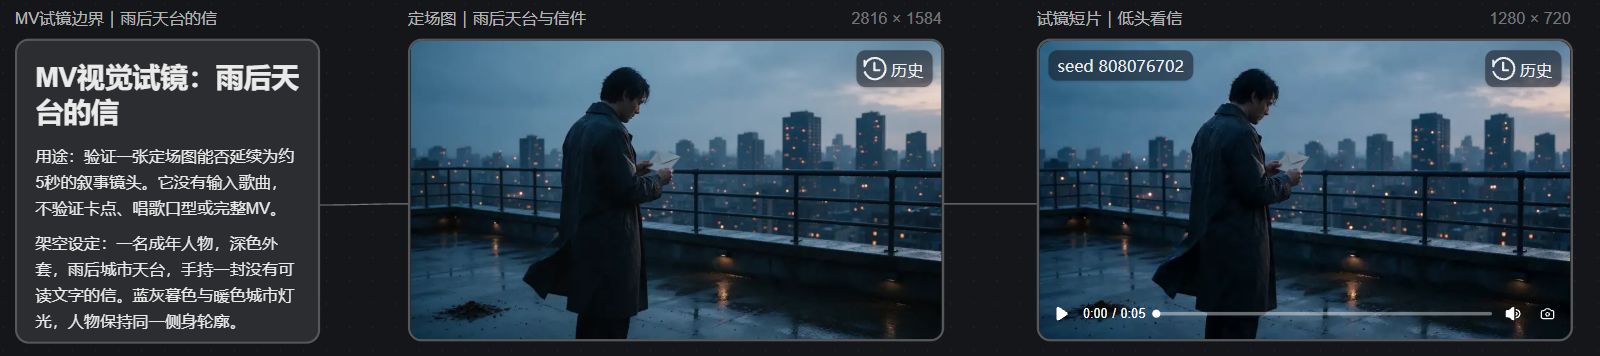
这个案例由我为文章构造,没有使用真实歌曲、艺人肖像或现成 MV 画面。在纳逗Pro案例画布里,我把“试镜边界说明 → 雨后天台定场图 → 低头看信短片”连成三节点流程。纳逗Pro官方媒体生成说明可用于核对平台当前的视频功能;具体模型输入和规格仍以本次实际提交与回执为准。
定场图由 Seedream 5.0 Pro 生成,实际尺寸为 2816×1584。画面里只有一名深色长外套人物,侧身站在栏杆内侧低头看信;雨后地面、蓝灰城市和少量暖色灯光提供了清楚的空间与色彩参考。选择这个场景,是为了先核对人物、外套、信件与雨后灯光的关系,而不是模拟演唱。
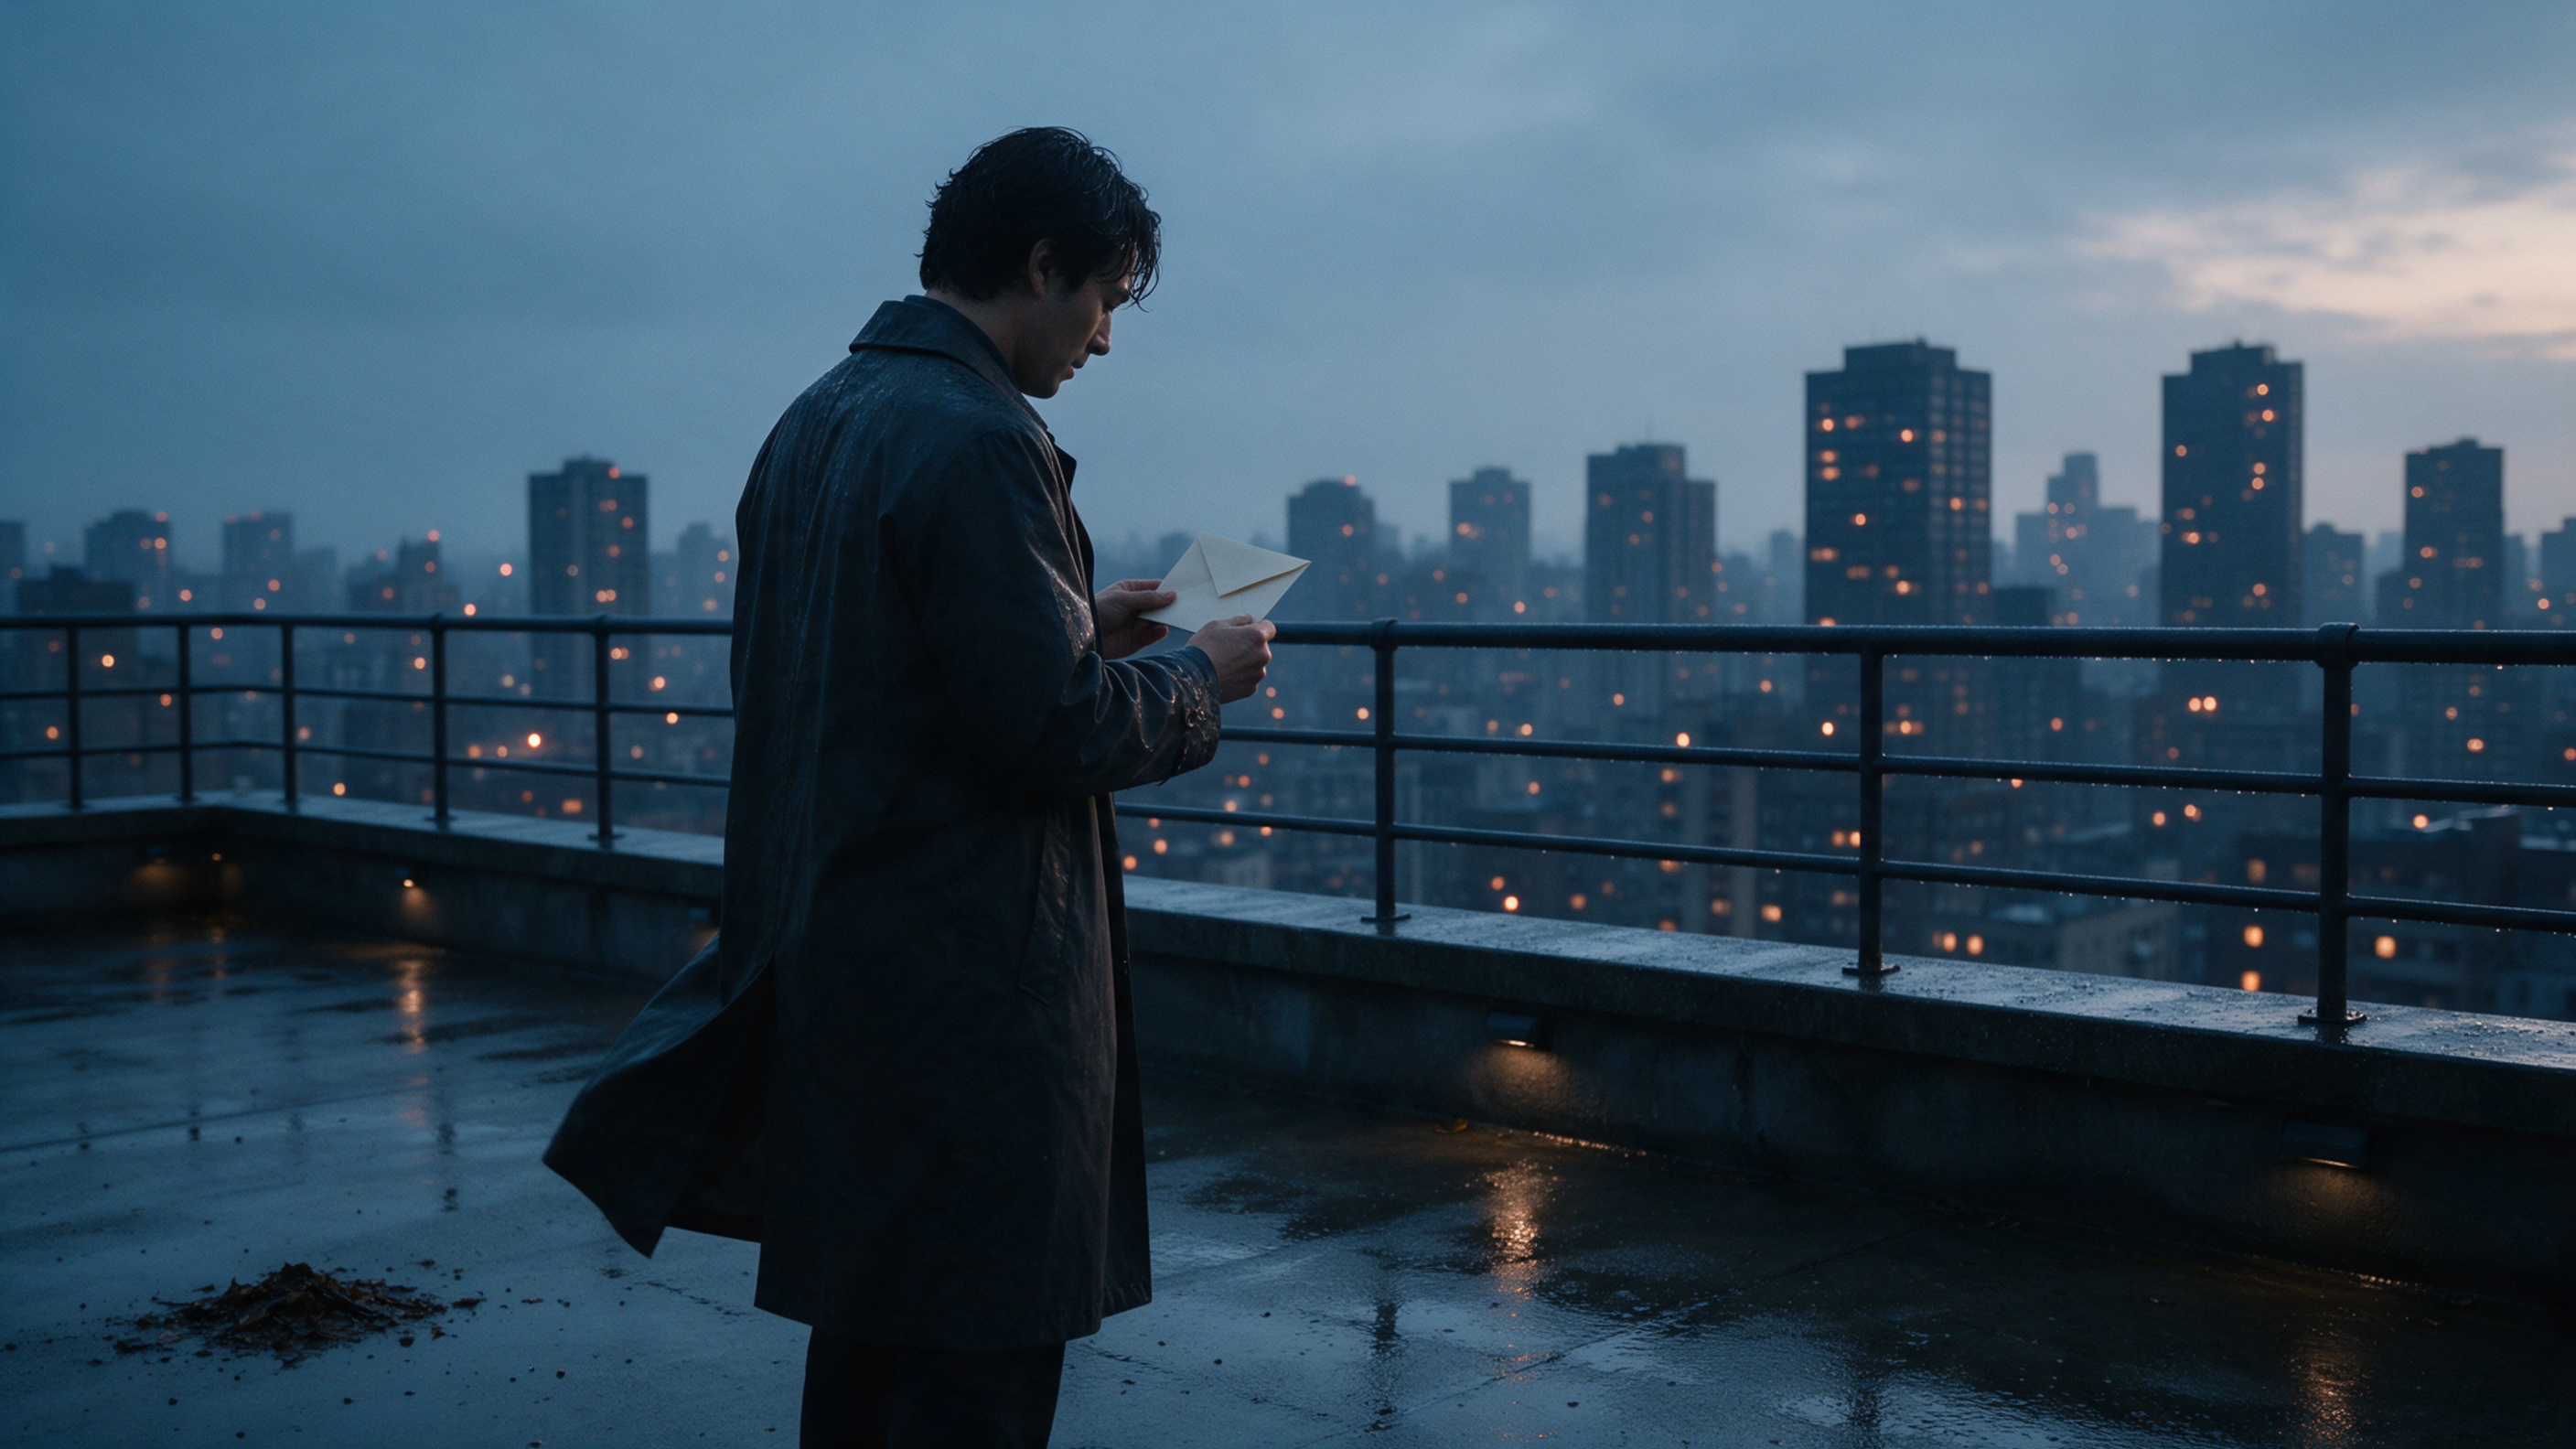
随后以这张图为参考,用 Seedance 2.0 Mini 生成一条 1280×720、约 5 秒、无音频的单镜视频。在线目视可见人物、信件、栏杆与城市灯光保持在同一空间中,外套有轻微摆动,镜头没有切场。这个样片只能检验静帧到短镜头的延续;没有歌曲时间线,也不能证明卡点准确或嘴部与歌词同步。
下图是本次真实画布网页截图,可同屏查看说明、定场图、短片和连接线。
卡点、口型和剪辑是下一步
卡点: 将已确定版权和版本的原曲放进时间线,按歌词、重音和情绪变化安排切点,再连画面完整观看。只有听歌曲,检查不出视觉切换是否过早或过晚。本次样片没有歌曲,不能当作卡点结果。
口型: 如果需要演唱特写,应截一小句原曲,确认所选功能是否支持原音频驱动或口型同步,再看实际音素、节奏与唱法是否吻合。嘴唇轻动并不等于准确跟唱;不合格时可改用不露正面口型的叙事镜头,或走专门的口型处理流程。
成片: 继续生成所需镜头,在剪辑时间线比较人物、手部、道具、背景和画面接缝。歌词字幕要另行校对文字及出现时间,确认原曲没有被生成素材的声音覆盖。歌曲、肖像与参考素材也要留有适用授权。先让一小段能独立看完,再扩展到全曲。