
AI 怎麼做 MV 影片:用納逗Pro從歌曲做到成片
AI 怎麼做 MV 影片:用納逗Pro從歌曲做到成片
我在納逗Pro畫布裡做了一次「雨後天台看信」的無聲 MV 視覺試鏡:先生成一張定場圖,再以它為參考生成約 5 秒的單鏡短片。兩次提交前估價分別為 3 積分和 7 積分,合計預計 10 積分。這個小樣只檢驗畫面延續和輕動作,沒有輸入歌曲,不代表已經完成卡點、演唱口型或整支 MV。
直接回答: 用 AI 做 MV,應先鎖定歌曲版本,標出歌詞段落、重音和停頓;再確定角色與視覺參考,逐鏡生成短素材,最後在歌曲時間線上剪輯、校對音畫和導出。敘事鏡頭、演唱特寫和歌詞字幕的驗收要求不同。單個畫面生成得好看,不足以證明整首歌的節奏、口型和版權問題都已解決。
先把歌曲變成可以執行的時間表
歌曲版本最先定下來。前奏長度或速度一變,已有剪輯點就可能全部需要重排。至少聽兩遍:第一遍記主歌、副歌、間奏和收尾的起止時間,第二遍記重音、停頓及情緒轉折。不懂 BPM,也可以先從這些可聽見的變化開始。
下面是一段虛構的約 30 秒副歌 的分鏡示例,不是本次畫布已完成的鏡頭數,也不是平台時長限制。製作時應把「副歌進入」等詞換成所用歌曲的準確時間碼。
音樂位置 | 畫面任務 | 驗收重點 |
|---|---|---|
副歌進入 | 天台遠景交代人物與城市 | 位置和光線方向清楚 |
情緒上升 | 中景停步、低頭看信 | 人物、外套與信件連續 |
關鍵歌詞 | 面部或信件特寫 | 情緒與歌詞對應,不強行逐字配圖 |
尾音延長 | 背影或城市空鏡 | 畫面停留時間足夠 |
每鏡只安排一個主要動作,比把奔跑、轉身、擁抱和流淚都塞進幾秒更容易生成和返工。鏡頭切換要服務於重音、動作完成或情緒變化,不必每一拍都切。
把抽象情緒寫成可見鏡頭
「雨夜、電影感、孤獨」只交代氛圍,還應寫清人物位置、動作、景別、機位和結束狀態。例如:雨後天台,一名穿深色外套的成年人站在欄杆內側,低頭看一封信;中景固定機位,遠處是藍灰暮色與暖色窗燈,人物不說話。這樣的描述更便於檢查信件、衣服和背景是否穩定。
先選能代表人物與場景的參考圖,記錄髮型、衣著、道具、主色和光線方向,再出關鍵靜幀。把靜幀按播放順序排在一起,確認它們像同一支作品後再做動態鏡頭。參考圖能幫助表達目標,不能保證跨鏡頭完全一致。
真實畫布案例:雨後天台的無聲視覺試鏡
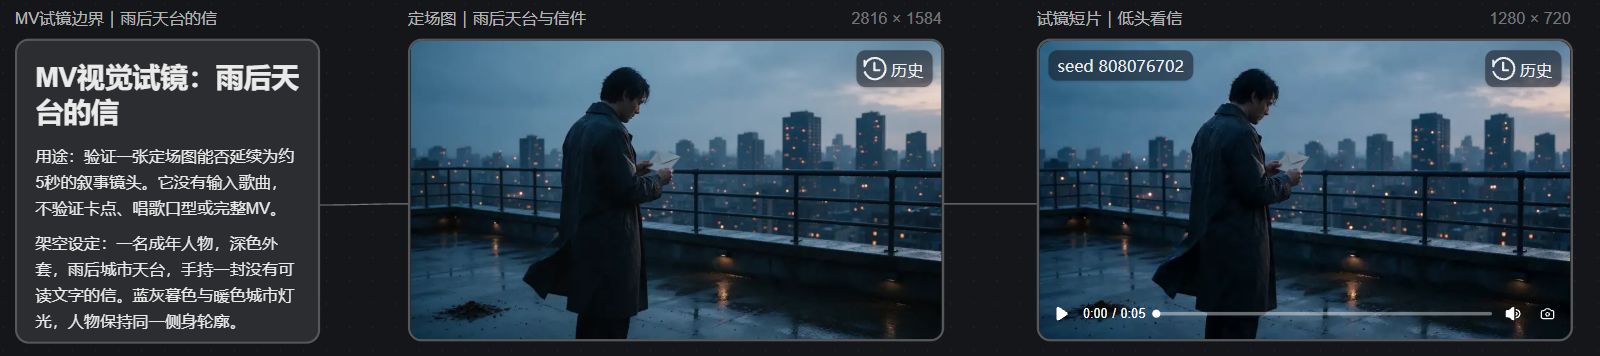
這個案例由我為文章構造,沒有使用真實歌曲、藝人肖像或現成 MV 畫面。在納逗Pro案例畫布裡,我把「試鏡邊界說明 → 雨後天台定場圖 → 低頭看信短片」連成三節點流程。納逗Pro官方媒體生成說明可用於核對平台當前的影片功能;具體模型輸入和規格仍以本次實際提交與回執為準。
定場圖由 Seedream 5.0 Pro 生成,實際尺寸為 2816×1584。畫面裡只有一名深色長外套人物,側身站在欄杆內側低頭看信;雨後地面、藍灰城市和少量暖色燈光提供了清楚的空間與色彩參考。選擇這個場景,是為了先核對人物、外套、信件與雨後燈光的關係,而不是模擬演唱。
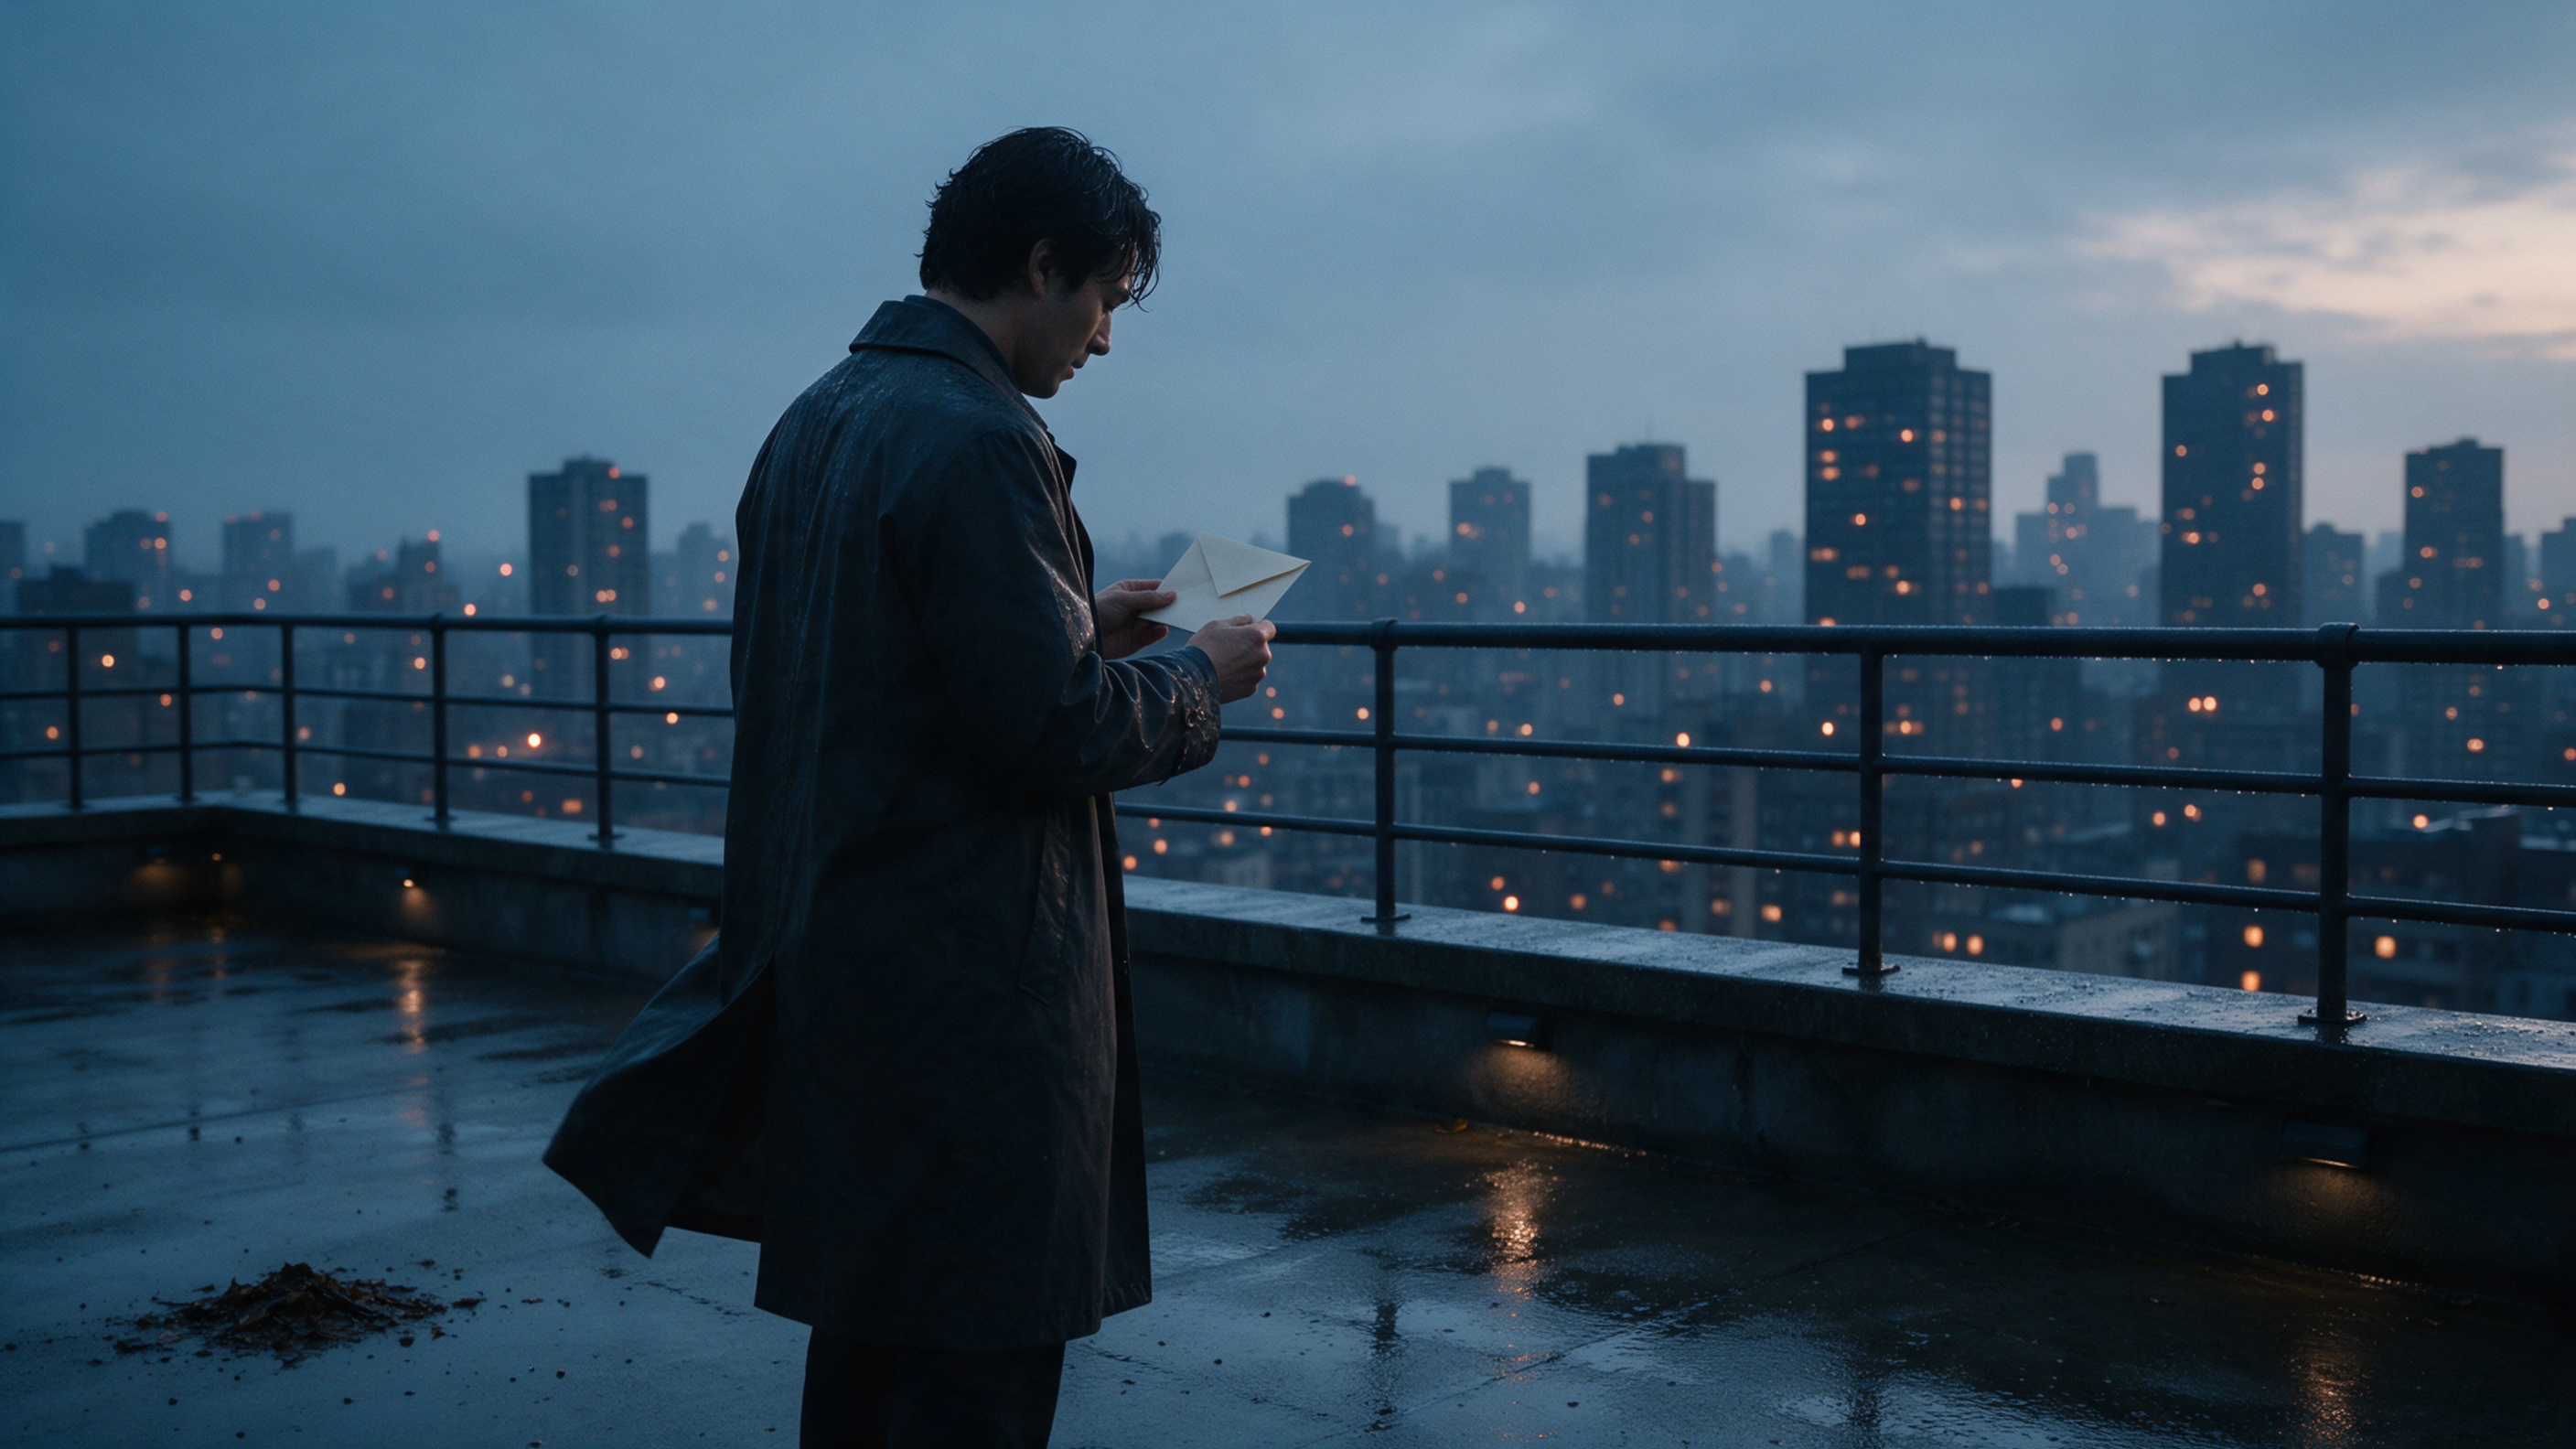
隨後以這張圖為參考,用 Seedance 2.0 Mini 生成一條 1280×720、約 5 秒、無音頻的單鏡影片。線上目視可見人物、信件、欄杆與城市燈光保持在同一空間中,外套有輕微擺動,鏡頭沒有切場。這個樣片只能檢驗靜幀到短鏡頭的延續;沒有歌曲時間線,也不能證明卡點準確或嘴部與歌詞同步。
下圖是本次真實畫布網頁截圖,可同屏查看說明、定場圖、短片和連接線。
卡點、口型和剪輯是下一步
卡點: 將已確定版權和版本的原曲放進時間線,按歌詞、重音和情緒變化安排切點,再連畫面完整觀看。只有聽歌曲,檢查不出視覺切換是否過早或過晚。本次樣片沒有歌曲,不能當作卡點結果。
口型: 如果需要演唱特寫,應截一小句原曲,確認所選功能是否支援原音頻驅動或口型同步,再看實際音素、節奏與唱法是否吻合。嘴唇輕動並不等於準確跟唱;不合格時可改用不露正面口型的敘事鏡頭,或走專門的口型處理流程。
成片: 繼續生成所需鏡頭,在剪輯時間線比較人物、手部、道具、背景和畫面接縫。歌詞字幕要另行校對文字及出現時間,確認原曲沒有被生成素材的聲音覆蓋。歌曲、肖像與參考素材也要留有適用授權。先讓一小段能獨立看完,再擴展到全曲。